

Многие до сих пор воспринимают PDF как некий неприкосновенный формат, который поисковик либо понимает целиком, либо игнорирует полностью. На деле всё устроено гораздо интереснее и, пожалуй, даже парадоксальнее. Когда я впервые углубилась в эту тему, меня не покидало ощущение, что речь идёт не о технической особенности, а о целом пласте недопонимания между теми, кто создаёт документы, и теми, кто их индексирует. Оказалось, что между файлом и поисковой выдачей происходит целая цепочка превращений, о которой редко задумываются даже опытные веб-мастера.
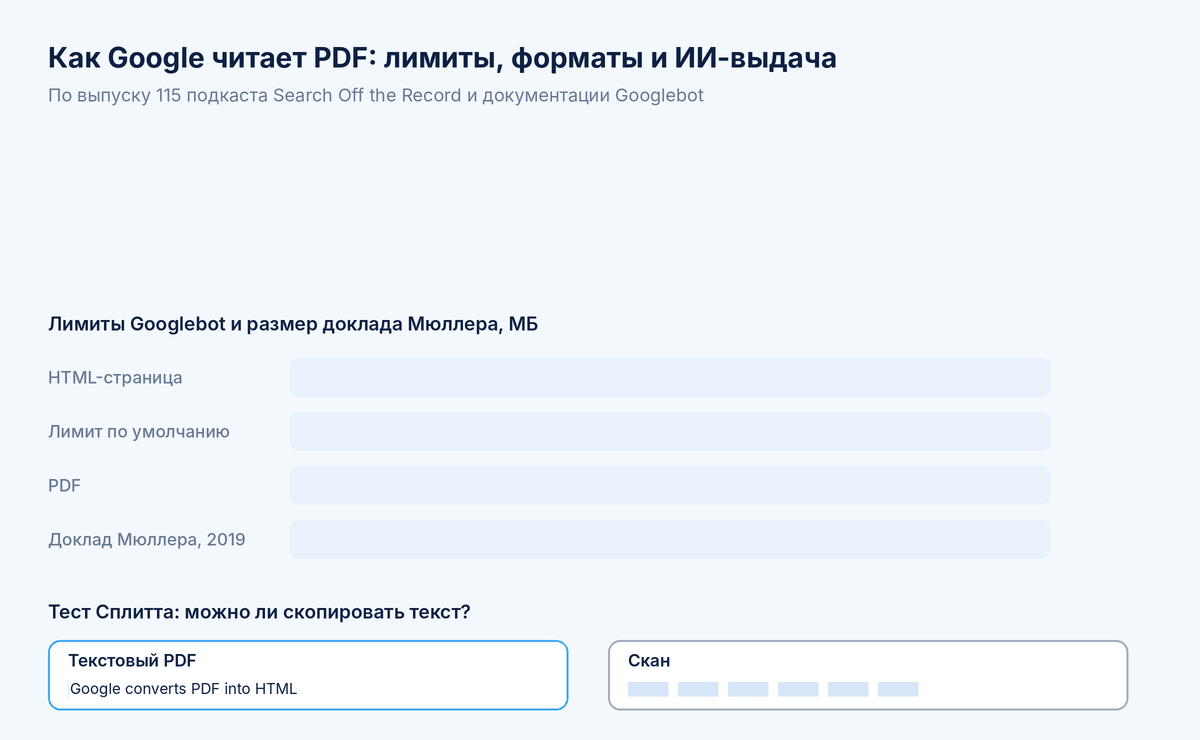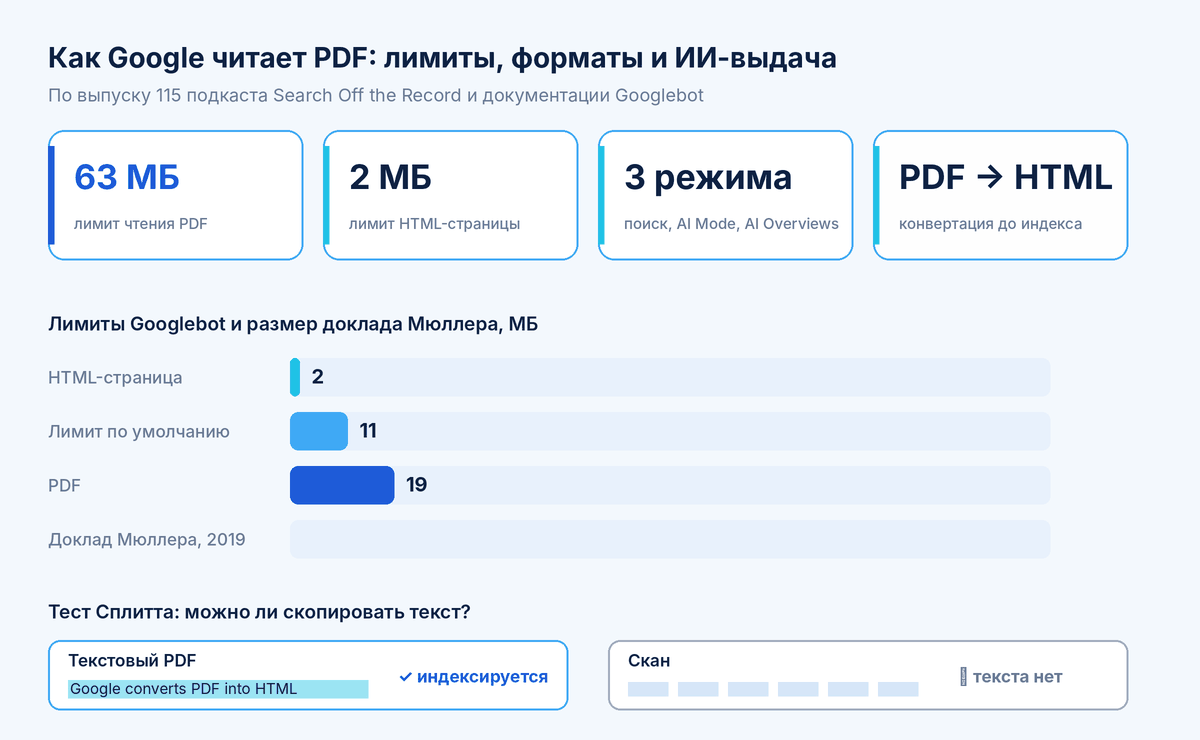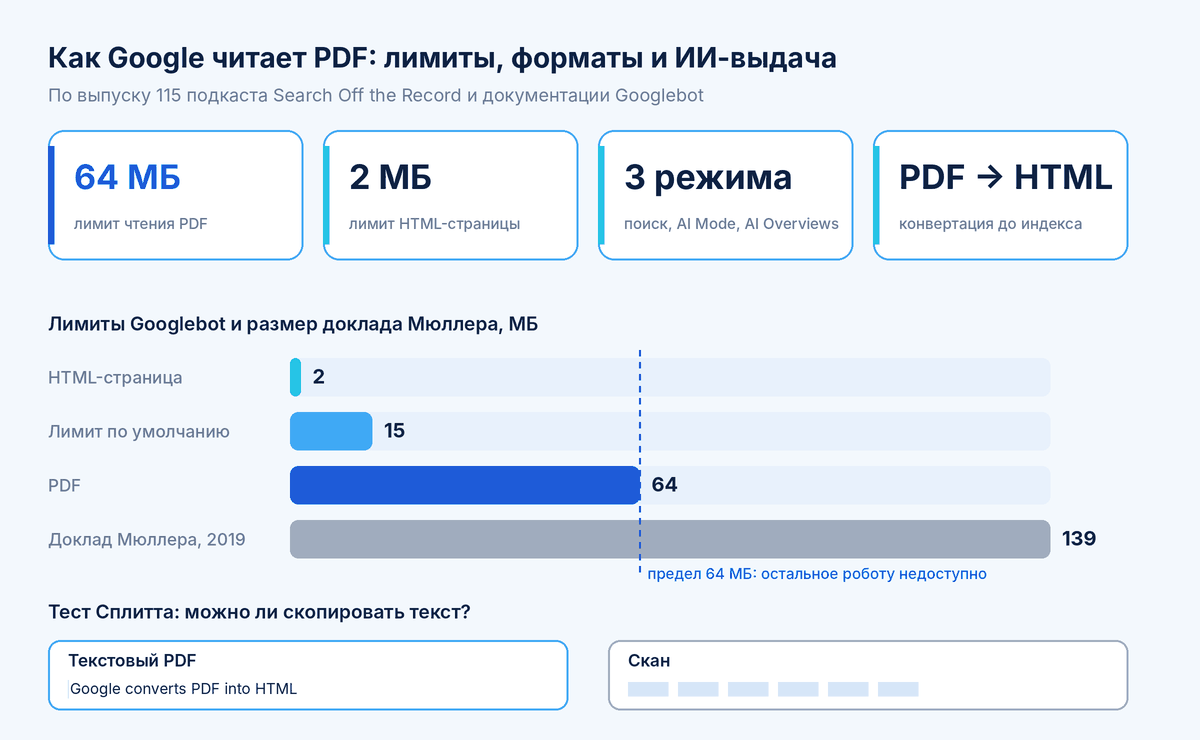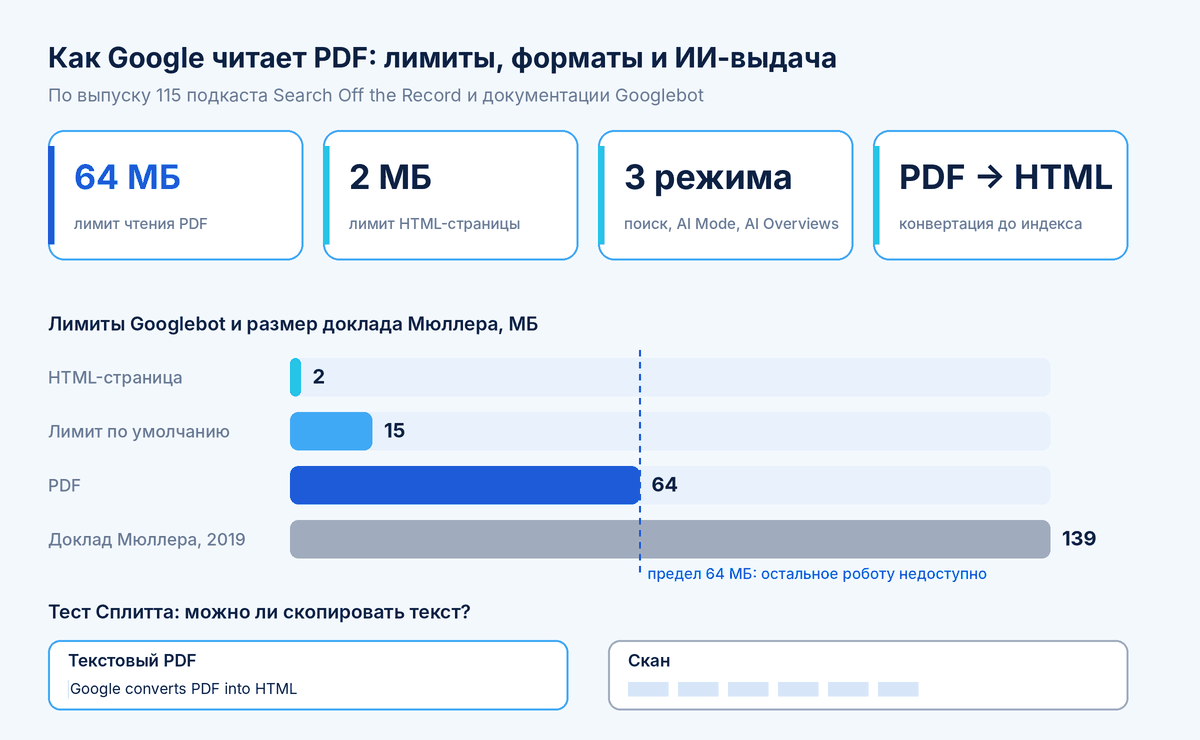
Самое удивительное, что наглядный урок всем нам преподали ещё в 2019 году, когда Министерство юстиции США опубликовало знаменитый доклад спецпрокурора Роберта Мюллера. Документ объёмом 448 страниц и весом около 139 мегабайт стал объектом пристального внимания журналистов по всей стране. Казалось бы, вот он — идеальный случай для быстрого поиска по ключевым фамилиям и событиям. Однако реальность оказалась обескураживающей: каждая страница представляла собой изображение без какого-либо текстового слоя. Специалисты PDF Association позже выдвинули предположение, что документ сначала распечатали, затем отсканировали, а после редактирования секретных фрагментов, вероятно, отсканировали повторно. Технический директор Appligent Document Solutions Марк Гэвин тогда охарактеризовал такой PDF как «really kind of sad», что можно перевести как «по-настоящему печальное зрелище». И с ним трудно не согласиться.
Спустя семь с половиной лет после той истории случился другой показательный эпизод. В октябре 2026 года сотрудник Google по связям с поисковым сообществом Джон Мюллер и его коллега Мартин Сплитт посвятили целый выпуск подкаста Search Off the Record теме PDF в поиске. Разговор шёл о индексации, искусственном интеллекте и типичных ошибках. И вот что важно: многое из сказанного прозвучало как запоздалое объяснение той самой ситуации с докладом Минюста.
Невидимая конвертация: как PDF превращается в HTML
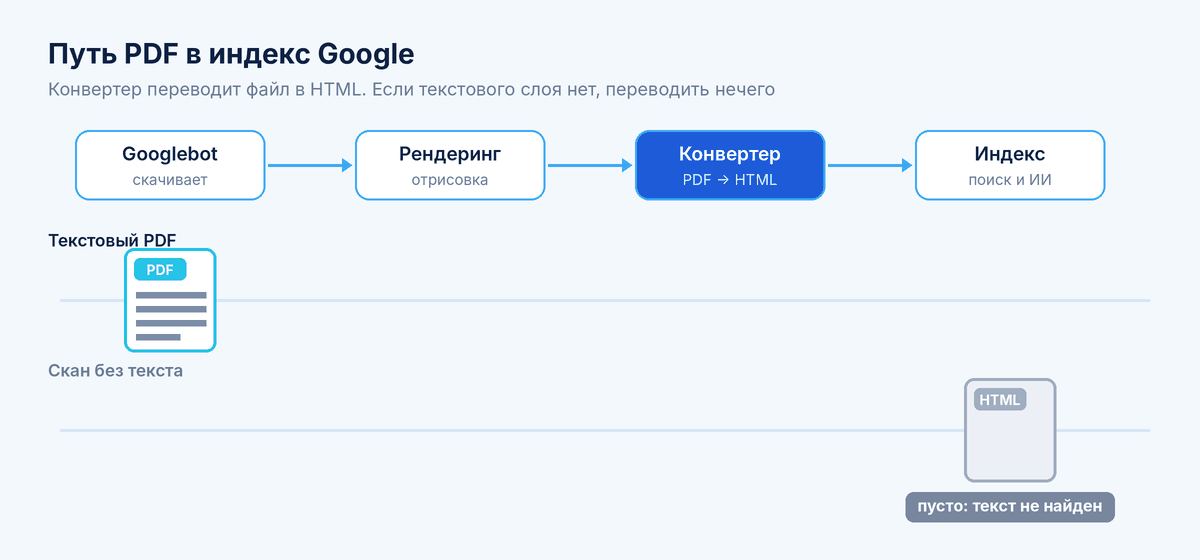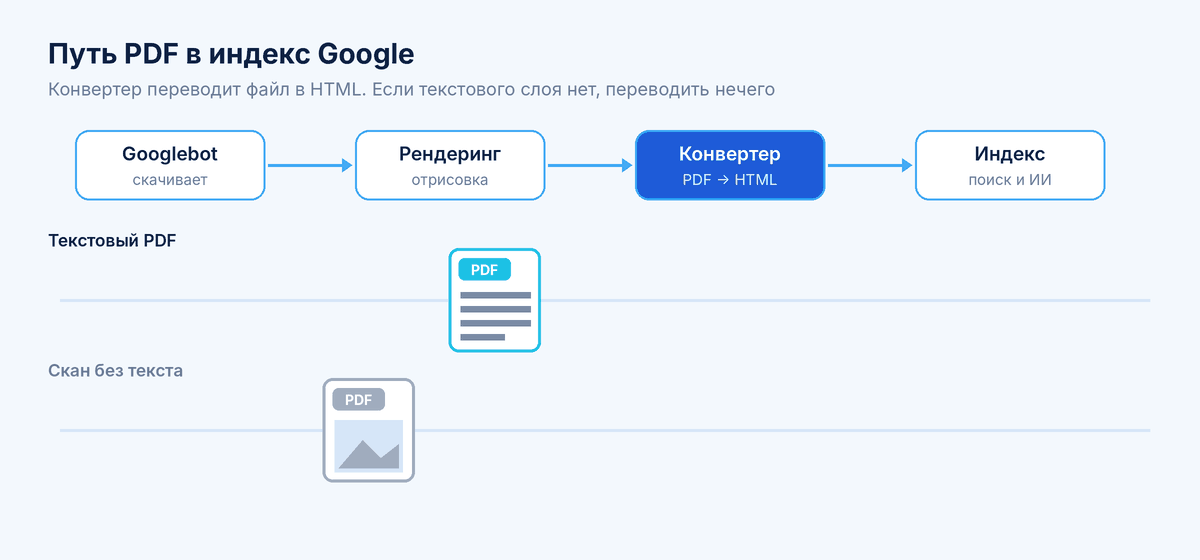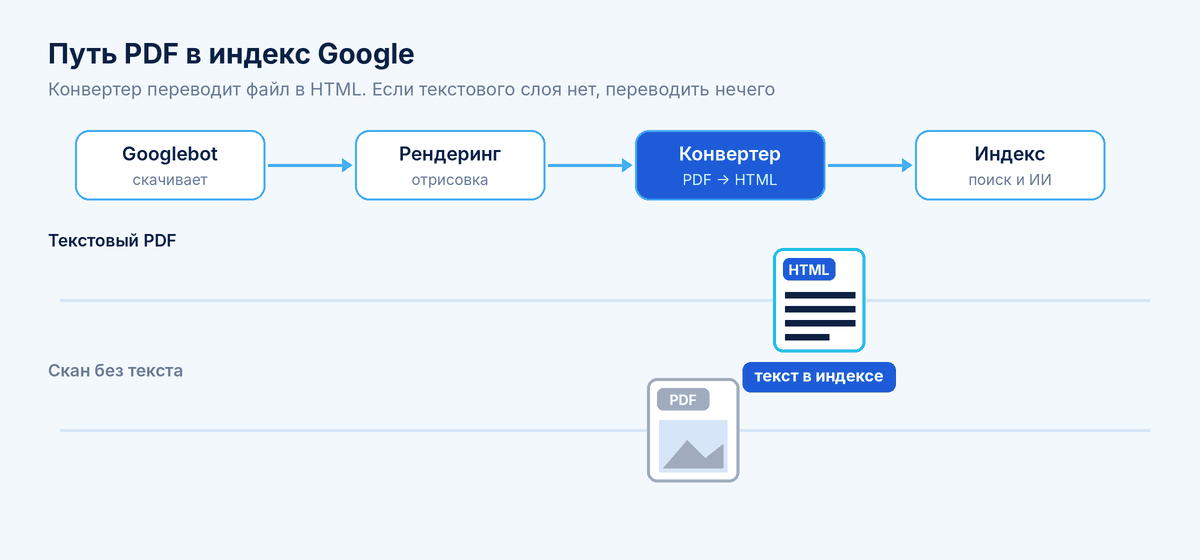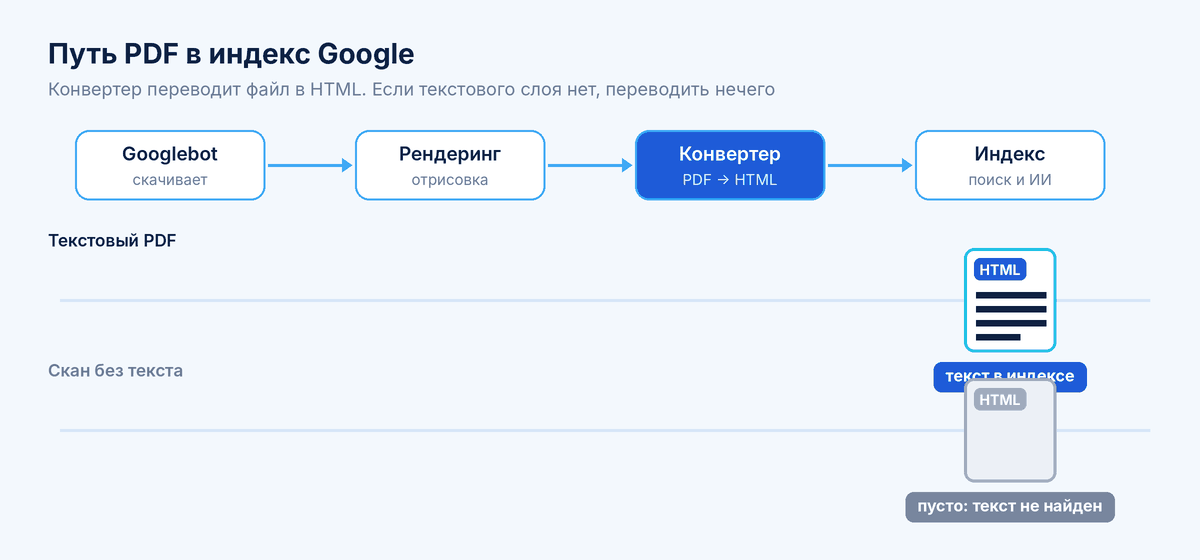
Главное откровение выпуска оказалось до смешного простым, но оттого не менее важным. Google не читает PDF в том виде, в котором его открывает человек в программе просмотра. Внутри поисковой системы существует специальный компонент, который инженеры называют конвертером. Его задача — взять исходный файл и перевести его в HTML, то есть в формат, с которым поисковый конвейер работает наиболее уверенно. Фактически весь дальнейший процесс имеет дело уже не с оригинальным PDF, а с его HTML-двойником.
Джон Мюллер сформулировал это с прагматизмом человека, которому некогда разводить техническую мистику. По его словам, Google превращает PDF в то, «с чем у него больше практики». Звучит просто, но за этой фразой скрывается фундаментальный принцип: поисковик не обязан любить все форматы одинаково, ему достаточно уметь приводить их к общему знаменателю.
Если разложить процесс по шагам, получается следующая последовательность. Сначала Googlebot скачивает файл. Затем запускается рендеринг — техническая отрисовка содержимого. После этого конвертер переводит результат в HTML, стараясь максимально точно передать оригинал. И только потом HTML-версия попадает в индекс и начинает жить по тем же правилам, что и любая обычная веб-страница. Аналогичный принцип, судя по словам Мартина Сплитта, действует и для других форматов: текстовых документов и электронных таблиц. В официальной справке Google Search Central PDF значится среди поддерживаемых закодированных форматов. Под закодированными там понимаются бинарные многослойные контейнеры, для разбора которых нужен отдельный парсер, умеющий извлекать текстовое содержимое.
Отсюда следует важный вывод: PDF не является для Google чёрным ящиком. Это скорее бумага, которая на входе в индекс переодевается веб-страницей. И от того, насколько качественно пройдёт это переодевание, зависит дальнейшая судьба документа в поиске.
Лимиты, ссылки и картинки: неочевидные ограничения
Один из самых человечных моментов подкаста случился, когда разговор зашёл о размерах файлов. Ведущие честно признались, что точного лимита для PDF не помнят. Сплитт лишь предположил, что он больше, чем у обычной страницы. Ирония в том, что ответ давно зафиксирован в собственной документации Google. Издание PPC Land не поленилось сверить цифры, и картина получилась довольно любопытной.
Для PDF робот скачивает первые 64 мегабайта файла. Для HTML-страницы лимит составляет 2 мегабайта, хотя ещё до февраля 2026 года он равнялся 15 мегабайтам. А значение по умолчанию для краулеров без собственного лимита — 15 мегабайт. Если вернуться к тому самому докладу Мюллера весом около 139 мегабайт, становится очевидно: сегодня Googlebot прочитал бы меньше половины, даже если бы в файле был текстовый слой.
Отдельного внимания заслуживают ссылки внутри PDF. Они работают как обычные гиперссылки, потому что переносятся в HTML-версию. Это значит, что через PDF-файл робот может находить другие страницы сайта. Мелочь, но в стратегии внутренней перелинковки она может сыграть свою роль.
С изображениями внутри PDF ситуация сложнее. У них нет собственного URL, поэтому обрабатывать их как обычные картинки Google не может. Сплитт допустил, что какая-то информация из них всё же извлекается, но твёрдо обещать ничего не стал. Практический вывод, который делают эксперты Search Engine Journal, звучит жёстко: считать, что картинки внутри PDF не индексируются. Для тех, кто привык прятать ключевые данные в графических элементах, это повод серьёзно пересмотреть подход.
Проблема обновлений и вопрос оригинальности
Ещё один нюанс, о котором редко задумываются, — свежесть документа. Google перекачивает PDF редко, поэтому исправленный файл по старому адресу может долго висеть в выдаче в прежнем виде. Джон Мюллер дал совет, который многим покажется радикальным: при существенных изменениях «it can make sense to just use a new file name», то есть имеет смысл просто дать файлу новое имя. Звучит неожиданно, но в контексте медленного пересканирования это действительно рабочий способ ускорить обновление.
По данным, которые Гэри Иллиш из Google, как сообщается, приводил на Search Central Live в Барселоне 2 октября 2026 года, обнаружение нового URL занимает около 20 часов, а повторное сканирование известного — около 30 дней. Цифры взяты из пересказа участника конференции, поэтому относиться к ним стоит как к ориентиру, но общая тенденция очевидна: новый адрес работает быстрее, чем ожидание повторного обхода.
С дублями тоже есть свои сложности. PDF-файлы часто перезаливают на чужие сайты побайтово, и Google трудно понять, где оригинал. Мюллер советует указывать каноническую версию через HTTP-заголовок rel="canonical", поскольку в сам PDF тег не вставишь, и ставить заметную ссылку на файл с главной страницы. Такой подход помогает поисковику отличить первоисточник от перезаливщиков.
PDF в эпоху генеративного поиска
Когда значительная часть SEO-индустрии переименовала себя в GEO — оптимизацию под генеративные ответы нейросетей — главный вопрос звучал предсказуемо: видят ли PDF новые ИИ-режимы Google. Ответ Сплитта и Мюллера оказался спокойным и обнадёживающим. Видят. PDF может появляться и в обычной поисковой выдаче, и в AI Mode, разговорном режиме поиска, и в AI Overviews, сводных ИИ-ответах над результатами.
По словам Сплитта, индексация и ранжирование PDF устроены практически так же, как у любого другого документа. Особого штрафа за формат нет, как нет и особой премии. Однако есть принципиальные ограничения. Растрированные PDF, то есть сканы и «плоские» страницы, теряют текстовый слой и не могут ранжироваться по своему тексту. Информация, спрятанная в картинках внутри файла, скорее всего, для поиска и ИИ-ответов не существует. А обновления доходят до выдачи медленно, и ИИ-ответ, собранный по устаревшей версии, хуже, чем никакого.
Отдельной строкой ведущие прошлись по модному llms.txt — текстовому файлу, который некоторые сайты выкладывают специально для языковых моделей. Полагаться на него они не советуют, а Мюллер добавил, что PDF для такой роли точно не подходит. Если перевести всё это на язык прессы, получается так: нейросеть не ненавидит PDF, она просто читает его через переводчика, и всё, что переводчик не смог разобрать, остаётся за кадром. Сканированный доклад 2019 года для ИИ-ответа был бы пустой коробкой с красивой обложкой.
Когда PDF действительно оправдан
На вопрос, стоит ли вообще делать PDF, Сплитт ответил в своей манере: конечно, если контент того требует. Мюллер добавил, что смотрит на это прагматично, и предложил собственную иерархию. Если материал можно без потерь превратить в обычную веб-страницу, лучше HTML: его проще обрабатывать поисковикам и удобнее читать людям. Пример Сплитта звучит почти по-бытовому: меню ресторана в PDF лучше, чем никакого меню.
PDF оправдан, когда нужна точная верстка под печать, когда документ является формой или бланком, когда файл должен сохранить вид оригинала — прайс, инструкция, меню, каталог. Во всех остальных случаях стоит задуматься, не лучше ли отдать контент в HTML.
Технический чек-лист, который я для себя вынесла из этого разбора, выглядит так. Во-первых, проверяйте текстовый слой. Тест Сплитта прост: выделите весь текст, скопируйте в простой блокнот. Если текст вставился, Google его, скорее всего, прочитает. Во-вторых, не прячьте важное в картинки. Цифры, выводы, контакты должны быть текстом. В-третьих, следите за весом: всё, что лежит за пределом 64 мегабайт, роботу недоступно. В-четвёртых, обновляйте с умом: для существенных правок подумайте о новом имени файла и обновите ссылки на него. В-пятых, указывайте оригинал через канонический HTTP-заголовок и видимую ссылку с главной страницы. И наконец, дублируйте ключевой контент в HTML: статья на странице, а PDF как приложение для скачивания. Так материал работает и в поиске, и в ИИ-ответах, и в руках читателя.
Если свести все рекомендации к одной фразе, её, пожалуй, следовало бы повесить в каждом отделе, который выкладывает документы в сеть. Хороший PDF — это тот, из которого можно скопировать текст. Всё остальное — компромиссы, которые рано или поздно обернутся потерей видимости.
История с PDF на самом деле не про формат. Она про то, что любой сайт живёт двумя жизнями: одной для человека, другой для машины. Хорошая веб-студия думает об обеих сразу, ещё на этапе, когда клиент только прикидывает, какой сайт ему нужен. И если на вашем сайте до сих пор лежит прайс в виде скана, вы теперь знаете, с чего начать.