

Привычные программы живут по понятным правилам. Код написан однажды, дальше он просто крутится на вашем устройстве, и разработчику, по большому счету, все равно, открыли вы калькулятор один раз или тысячу. С искусственным интеллектом эта логика не работает в принципе. Когда я впервые задумалась о том, что происходит после нажатия кнопки «Отправить» в чат-боте, картина оказалась куда более промышленной, чем можно было предположить.
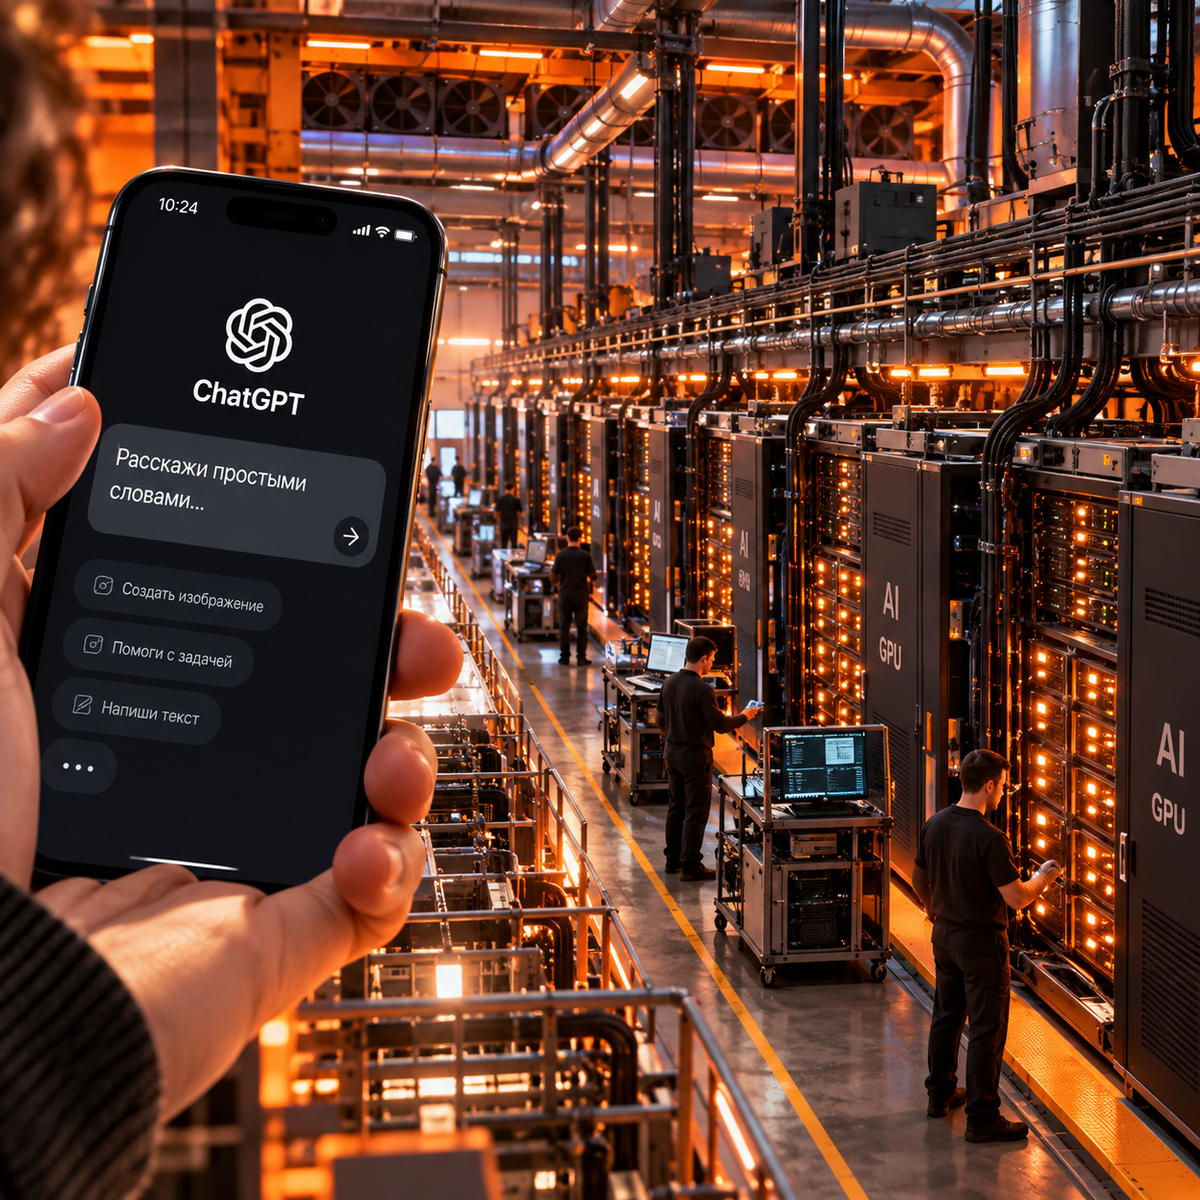
Свежие финансовые отчеты компаний, занимающихся разработкой ИИ, обнажают масштаб происходящего. Например, создатели одной известной языковой модели зафиксировали чистый убыток порядка сорока двух миллиардов долларов за прошлый год. И это не разовые вложения в исследования. Значительная часть расходов уходит на то, чтобы уже созданная система могла отвечать пользователям каждый день. Суммы будущих обязательств перед облачными провайдерами и поставщиками оборудования и вовсе измеряются сотнями миллиардов. По сути, мы имеем дело с непрерывным производственным процессом, замаскированным под обычный сайт.
Путь вашего вопроса: от браузера до серверной стойки
Когда я печатаю сообщение в окне нейросети, на моем ноутбуке не запускается никакой суперкомпьютер. Текст улетает через интернет в дата-центр, где находятся тысячи мощных ускорителей. Именно там начинается настоящая работа. Модель не просто ищет готовый ответ в базе данных. Она последовательно генерирует каждое слово, анализируя контекст и вычисляя вероятности. Чем длиннее и сложнее ответ, тем больше математических операций требуется выполнить.
Вся эта инфраструктура физически существует: серверы потребляют электричество, выделяют тепло, а системы охлаждения отводят его, чтобы оборудование не перегрелось. Мы не видим ничего из этого, потому что весь цикл укладывается в несколько секунд. Но за кажущейся мгновенностью скрывается вполне материальная инженерная система.
Эффект масштаба: когда миллиард мелочей превращается в гору
Один запрос действительно стоит немного. Проблема в том, что таких запросов невероятно много. Один человек просит исправить деловое письмо, другой загружает объемный документ, третий генерирует изображения, четвертый запускает сложного агента, который может работать несколько часов подряд. Каждое действие добавляет нагрузку на серверы. Когда пользователей сотни миллионов, даже минимальная стоимость одного обращения превращается в гигантский счет.
Именно это фундаментально отличает экономику ИИ от экономики традиционного софта. В классической модели новый пользователь приносит компании дополнительную выручку почти без дополнительных затрат. В случае с нейросетями каждый активный клиент одновременно создает и доход, и расходы. Чем больше людей пользуются сервисом, тем больше инфраструктуры нужно строить.
Почему новые модели особенно прожорливы
Разработчики постоянно наращивают возможности искусственного интеллекта. Современные системы умеют не только быстро продолжать текст, но и подолгу размышлять над сложной задачей, обращаться к внешним инструментам, анализировать изображения и писать код. Для меня как пользователя это выглядит как рост интеллекта. Для владельца сервиса — как рост счета за электричество.
Особенно показателен режим глубокого рассуждения. Простой вопрос обрабатывается быстро, а вот сложная задача заставляет систему выполнить значительно больше внутренних вычислений перед тем, как выдать результат. Добавьте к этому генерацию видео, голосовые модели и автономных агентов. Один пользователь сегодня способен создать нагрузку, которой несколько лет назад просто не существовало. Кнопка «думать дольше» имеет вполне конкретную цену, просто она не показывается в интерфейсе.
Агенты: когда одна команда запускает десятки процессов
Обычный чат-бот получает вопрос, отвечает и останавливается. Агент работает иначе. Получив задачу, он самостоятельно делает несколько шагов: анализирует информацию, открывает документы, обращается к другим сервисам, проверяет результат и при необходимости повторяет часть работы. Снаружи это выглядит как одна команда. Внутри — как множество обращений к модели и внешним инструментам.
Чем самостоятельнее становится агент, тем больше вычислений он выполняет без участия человека. Будущее, в котором у каждого из нас одновременно работает несколько цифровых помощников, звучит удобно. Но оно же создает колоссальный спрос на вычислительные мощности. Мы уже слышали о том, что дата-центрам начинает не хватать электричества. Теперь становится понятно, откуда берется такой аппетит.
Обучение: первая стадия гигантского конвейера
Все, о чем я говорила выше, касается только использования уже готовой нейросети. Но до этого ее нужно создать. Передовые модели обучаются на огромных вычислительных кластерах. Тысячи ускорителей в течение длительного времени обрабатывают данные, постепенно настраивая миллиарды внутренних параметров системы. После обучения начинаются дополнительные тесты, настройка поведения, работа над безопасностью и создание новых версий. Затем появляется следующая модель, и цикл повторяется.
Получается своеобразная фабрика. Компания постоянно строит новые мощности, обучает следующее поколение моделей и одновременно обслуживает миллионы пользователей предыдущего поколения. Все эти процессы идут параллельно, требуя непрерывных вложений.
Почему производитель чипов оказался в центре всего
Во время бума персональных компьютеров огромную ценность получили производители процессоров. Во время мобильной революции вырос спрос на чипы для смартфонов. ИИ-бум создал невероятный спрос на специализированные ускорители. Обычного серверного процессора для эффективной работы нейросети недостаточно. Нужны графические ускорители, которые отлично справляются с массовыми математическими операциями.
Один производитель такого оборудования стал ключевым бенефициаром всей истории. Но купить чипы мало. Их нужно объединить в огромные вычислительные системы, обеспечить высокоскоростной связью, памятью, электричеством и охлаждением. Строительство инфраструктуры для ИИ все больше напоминает создание промышленного предприятия. Только вместо станков внутри стоят серверные стойки.
Дата-центры: миллиарды долларов под неприметной крышей
Снаружи дата-центр иногда выглядит как большой склад без особых примет. Внутри находится одна из самых сложных инженерных систем современности. Тысячи серверов потребляют огромное количество энергии и выделяют не меньше тепла. Это тепло необходимо постоянно отводить, иначе оборудование выйдет из строя. Нужны трансформаторы, резервное питание, аккумуляторы, генераторы, системы охлаждения, сетевое оборудование и километры кабелей. Затем всю эту инфраструктуру нужно обслуживать круглосуточно.
Технологические компании сегодня обсуждают уже не только новые процессоры. Они заключают долгосрочные энергетические соглашения, строят собственную генерацию и ищут места, где можно быстро получить сотни мегаватт мощности. Искусственный интеллект из программной отрасли превращается в тяжелую инфраструктуру.
Бесплатный доступ: маркетинг или благотворительность?
Пользователь открывает сервис и ничего не платит. Возникает ощущение, что компания просто раздает доступ к дорогой технологии. На самом деле бесплатный пользователь — часть стратегии роста. Сервис привлекает огромную аудиторию, люди привыкают к технологии, после чего часть из них покупает подписку, а компании начинают платить за корпоративные продукты и API.
Подобная модель давно существует в интернете. Мы бесплатно пользуемся поиском и социальными сетями, потому что компании находят способ заработать на большой аудитории. Но с ИИ есть важное отличие. Каждый активный пользователь создает заметные вычислительные расходы. Поэтому компании постоянно экспериментируют с ограничениями, тарифами и уровнями доступа.
Почему фиксированная подписка не решает проблему
Предположим, человек платит двадцать долларов в месяц. Если он задает несколько вопросов в день, экономика вполне комфортна. Но другой пользователь за те же деньги ежедневно анализирует огромные документы, генерирует код, запускает сложные рассуждения и использует агентов. Нагрузка на инфраструктуру у этих двух людей совершенно разная, хотя платят они одинаково.
Отсюда появляются лимиты. Самые дорогие модели могут иметь ограничения на количество запросов, а дополнительные вычисления иногда продаются отдельно. В будущем тарифы станут еще сложнее. Пользователь будет платить не просто за доступ к нейросети, а за определенный объем вычислительной работы. ИИ постепенно начинает напоминать электричество или мобильный интернет: чем больше потребляешь, тем важнее учет.
Эффективность как главное поле битвы
Представим две нейросети одинакового качества. Первая требует в два раза больше вычислений для ответа, вторая способна выдавать такой же результат значительно дешевле. Для пользователя разница почти незаметна. Для компании она огромна. Если сервис обрабатывает миллиарды запросов, небольшое повышение эффективности превращается в экономию миллиардов долларов.
Именно поэтому разработчики так много внимания уделяют не только увеличению мощности моделей, но и их оптимизации. Лучший ИИ будущего не обязательно будет самым большим. Возможно, победит модель, которая способна давать почти такой же результат, используя значительно меньше электричества и вычислительных ресурсов.
Маленькие модели: не слабость, а расчет
На первый взгляд кажется логичным всегда использовать самую мощную нейросеть. Зачем нужны более слабые версии, если существует огромная модель, способная решать сложнейшие задачи? Ответ снова в экономике. Большинству запросов не требуется максимальный интеллект. Чтобы исправить опечатку, классифицировать письмо или составить простое резюме документа, нет смысла запускать самую дорогую систему.
Поэтому компании создают семейства моделей разного размера. Простые задачи отправляются на быстрые и дешевые модели, а сложные получают доступ к более мощным вычислениям. Для пользователя этот выбор со временем может стать незаметным. Система сама определит, сколько ресурсов необходимо для конкретной задачи. Это похоже на автомобиль, который автоматически решает, сколько мощности двигателя использовать в конкретный момент.
Локальный ИИ: когда вычисления переезжают к пользователю
Есть еще один способ уменьшить расходы на дата-центры. Некоторые задачи можно выполнять непосредственно на смартфоне или компьютере пользователя. Современные процессоры получают специальные блоки для работы с нейросетями. Небольшая модель может анализировать текст, обрабатывать фотографию или выполнять локальную автоматизацию без постоянной отправки данных в облако.
Для компании это выгодно, потому что часть вычислительной нагрузки оплачивает сам пользователь через электричество и собственное устройство. Для человека появляется дополнительный плюс в виде скорости и приватности, поскольку данные не обязательно отправлять на удаленный сервер. Но самые мощные модели пока слишком велики для обычного смартфона. Поэтому наиболее вероятен гибридный подход: простые задачи выполняются локально, а сложные отправляются в дата-центр.
Невидимая стоимость привычных действий
Представьте, что каждый запрос к поисковику требовал запуска маленькой электростанции на несколько секунд. Пользователь быстро начал бы задумываться, действительно ли ему нужен очередной запрос. С нейросетями вся инфраструктура спрятана настолько хорошо, что появляется ощущение практически бесплатного интеллекта. Мы можем попросить переписать одно предложение пять раз, затем изменить тон, вернуть предыдущий вариант и после этого вообще закрыть вкладку.
Где-то в дата-центре все это время выполнялась настоящая вычислительная работа. Конечно, один конкретный запрос не разоряет компанию и не вызывает энергетическую катастрофу. Важен общий масштаб, когда подобное поведение одновременно повторяют сотни миллионов людей. Именно этот масштаб заставляет индустрию строить все больше инфраструктуры.
Гонка за дешевизной: следующая глава
Сегодня технологические компании любят показывать результаты тестов. Новая модель стала лучше программировать, решать математические задачи и понимать сложные инструкции. Но если две системы для обычного пользователя работают практически одинаково, экономика начинает играть огромную роль. Компания, которая научится предоставлять тот же интеллект в два раза дешевле, сможет снизить цену подписки, дать больше бесплатных запросов или просто получать больше прибыли.
Поэтому эффективность становится одним из главных полей конкуренции. Нужны более экономичные чипы, более эффективные модели, лучшее охлаждение, дешевое электричество и умное распределение запросов между разными системами. За красивым окном чат-бота разворачивается настоящая промышленная гонка.
Ставки, которые пока сложно осознать
Компании одновременно утверждают, что создают чрезвычайно мощный инструмент будущего, и тратят колоссальные деньги только на то, чтобы этот инструмент продолжал работать для растущей аудитории. Пока инвесторы готовы финансировать гонку, пользователи получают невероятно быстрый прогресс. Новые модели появляются одна за другой, возможности расширяются, а доступ к сложнейшим вычислениям иногда стоит дешевле обычной подписки на несколько онлайн-сервисов.
Но рано или поздно экономика должна сойтись. И тогда вопрос «сколько на самом деле стоит один хороший ответ искусственного интеллекта?» может оказаться намного важнее, чем кажется сегодня.
Бесплатный ИИ не обязательно останется таким навсегда
Это не означает, что бесплатные нейросети обязательно исчезнут. Бесплатный уровень слишком полезен для привлечения пользователей, поэтому компаниям выгодно его сохранять. Скорее изменится то, что именно будет доступно бесплатно. Простые и дешевые модели могут остаться практически без ограничений, а глубокие рассуждения, генерация видео, большие документы и автономные агенты постепенно будут сильнее привязаны к платным тарифам или лимитам.
Пользователь уже начинает видеть первые признаки такой модели. Не весь искусственный интеллект стоит одинаково, поэтому сервисам становится сложно продавать его как одну безграничную функцию. И чем мощнее становятся нейросети, тем заметнее будет эта разница.
За одной кнопкой действительно скрывается фабрика
В этом и заключается главный парадокс современного искусственного интеллекта. Мы видим максимально простой интерфейс: белое поле, курсор и кнопка отправки. Но после нажатия запускается огромная технологическая цепочка. Запрос проходит через интернет, попадает в дата-центр, обрабатывается дорогостоящими ускорителями, оборудование потребляет электричество и выделяет тепло, системы охлаждения отводят его, а через несколько секунд результат возвращается на экран.
Все это происходит ради нескольких абзацев текста, изображения или ответа на вопрос. Современный ИИ гораздо меньше похож на обычную программу, чем кажется. Это скорее глобальная вычислительная фабрика, к которой мы каждый раз подключаемся через маленькое окно браузера. И чем больше задач мы начинаем ей поручать, тем больше становится сама фабрика.
Что все это значит для обычного пользователя
Если бы рядом с каждым запросом к нейросети показывалась его реальная стоимость, изменилось бы наше отношение к ИИ? Стали бы мы реже просить переделывать один и тот же ответ или продолжили бы пользоваться системой точно так же? Мне кажется, большинство из нас просто не задумывается об этом. Удобство побеждает осознанность.
И еще интереснее другое: за какие функции искусственного интеллекта мы действительно готовы платить каждый месяц? За обычные ответы, работу с документами, генерацию изображений, программирование или только за агента, который способен самостоятельно выполнять реальную работу? Именно ответы обычных пользователей в конечном итоге определят, какая экономика у искусственного интеллекта вообще сможет работать. А пока мы просто продолжаем нажимать кнопку «Отправить», запуская невидимую фабрику снова и снова.